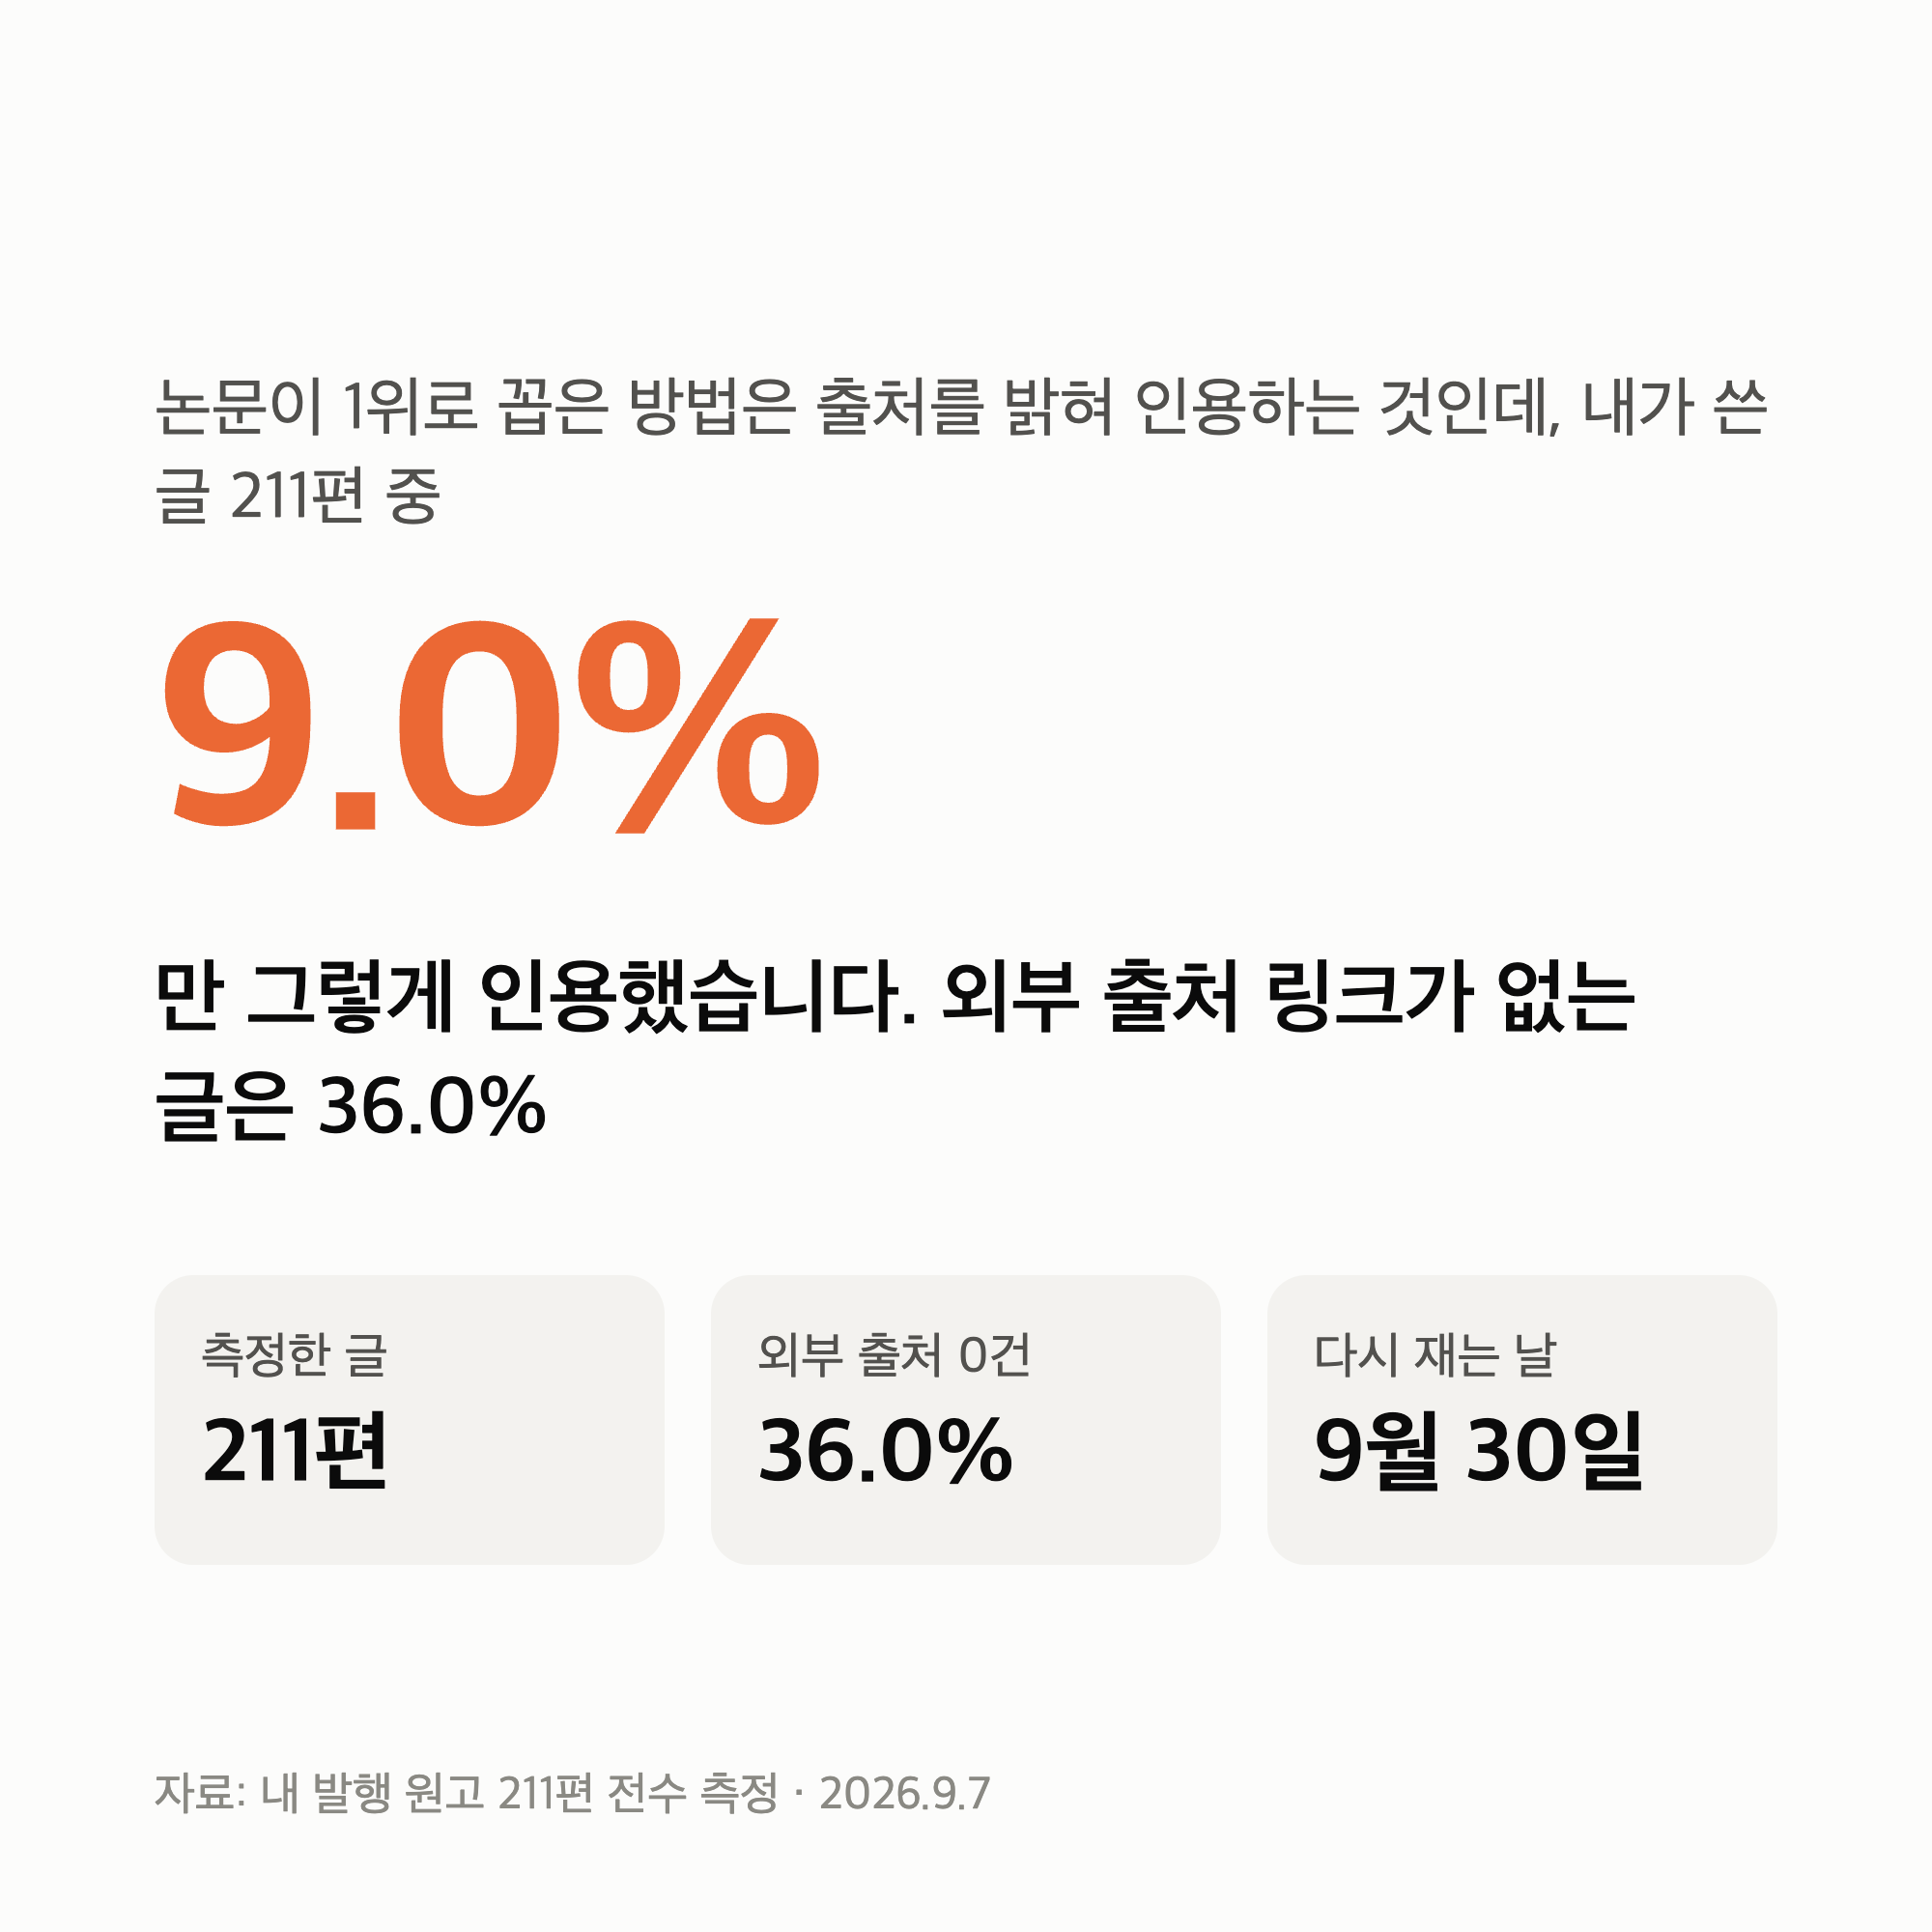
AI 인용되는 글쓰기의 1위 방법은 남의 말을 출처와 함께 인용하는 것인데, 제가 쓴 글 211편 중 그렇게 인용한 글은 9.0%뿐이었습니다. 외부 출처 링크가 한 줄도 없는 글은 36.0%였습니다.
규칙을 알았으니 이제 제 글을 재볼 차례입니다.
앞 글에서 질문 1만 개 규모 벤치마크로 아홉 가지 방법을 재본 논문과 클릭률 절반, 네이버 AI 브리핑 40% 목표를 봤습니다.
이 글은 그 규칙을 한국어 블로그 문장으로 옮기고, 제 글이 그 자로 몇 점인지 전수로 잰 기록입니다.
숫자는 제가 8월 25일부터 9월 8일까지 쓴 원고 211편을 프로그램으로 세어 얻었습니다. 남의 사례가 아니라 제 것입니다.
논문 1·2위 방법이 가장 잘 들어 있던 카테고리는 기업·산업분석과 정책·지원금입니다. 그런데 제 첫 AI 인용은 그 둘이 아니라 출처가 가장 빈 쪽에서, 그중 출처를 세 개 단 한 편에서 나왔습니다.
AI 인용되는 글쓰기는 다섯 문장으로 줄일 수 있습니다
논문이 실험한 아홉 가지 중 효과가 확인된 다섯 개를 제 블로그 문장으로 옮기면 이렇게 됩니다.
| 논문의 방법 | 내 글에서는 | 점수 | | 인용문 추가 | 기관 발표문을 따옴표로 그대로 | 27.2 | | 통계 추가 | 두루뭉술한 서술을 수치로 | 25.2 | | 문장 다듬기 | 한 문장에 한 가지만 | 24.7 | | 출처 인용 | 근거의 출처를 본문 안에 | 24.6 | | 쉽게 쓰기 | 전문용어에 풀이를 붙여 | 22.0 |
한 가지가 눈에 걸립니다. 다섯 개 중 셋은 새 정보를 넣는 것이 아니라 이미 있는 것을 드러내는 일입니다.
논문의 예시가 그 점을 보여줍니다.
스위스 초콜릿 소비량을 쓴 문장에 “국제초콜릿소비연구그룹 조사에 따르면"이라는 여덟 단어를 덧붙였더니 노출이 132.4% 늘었습니다.
내용은 그대로고 출처 이름만 붙였습니다.
그래서 제 글 211편을 같은 자로 재봤습니다
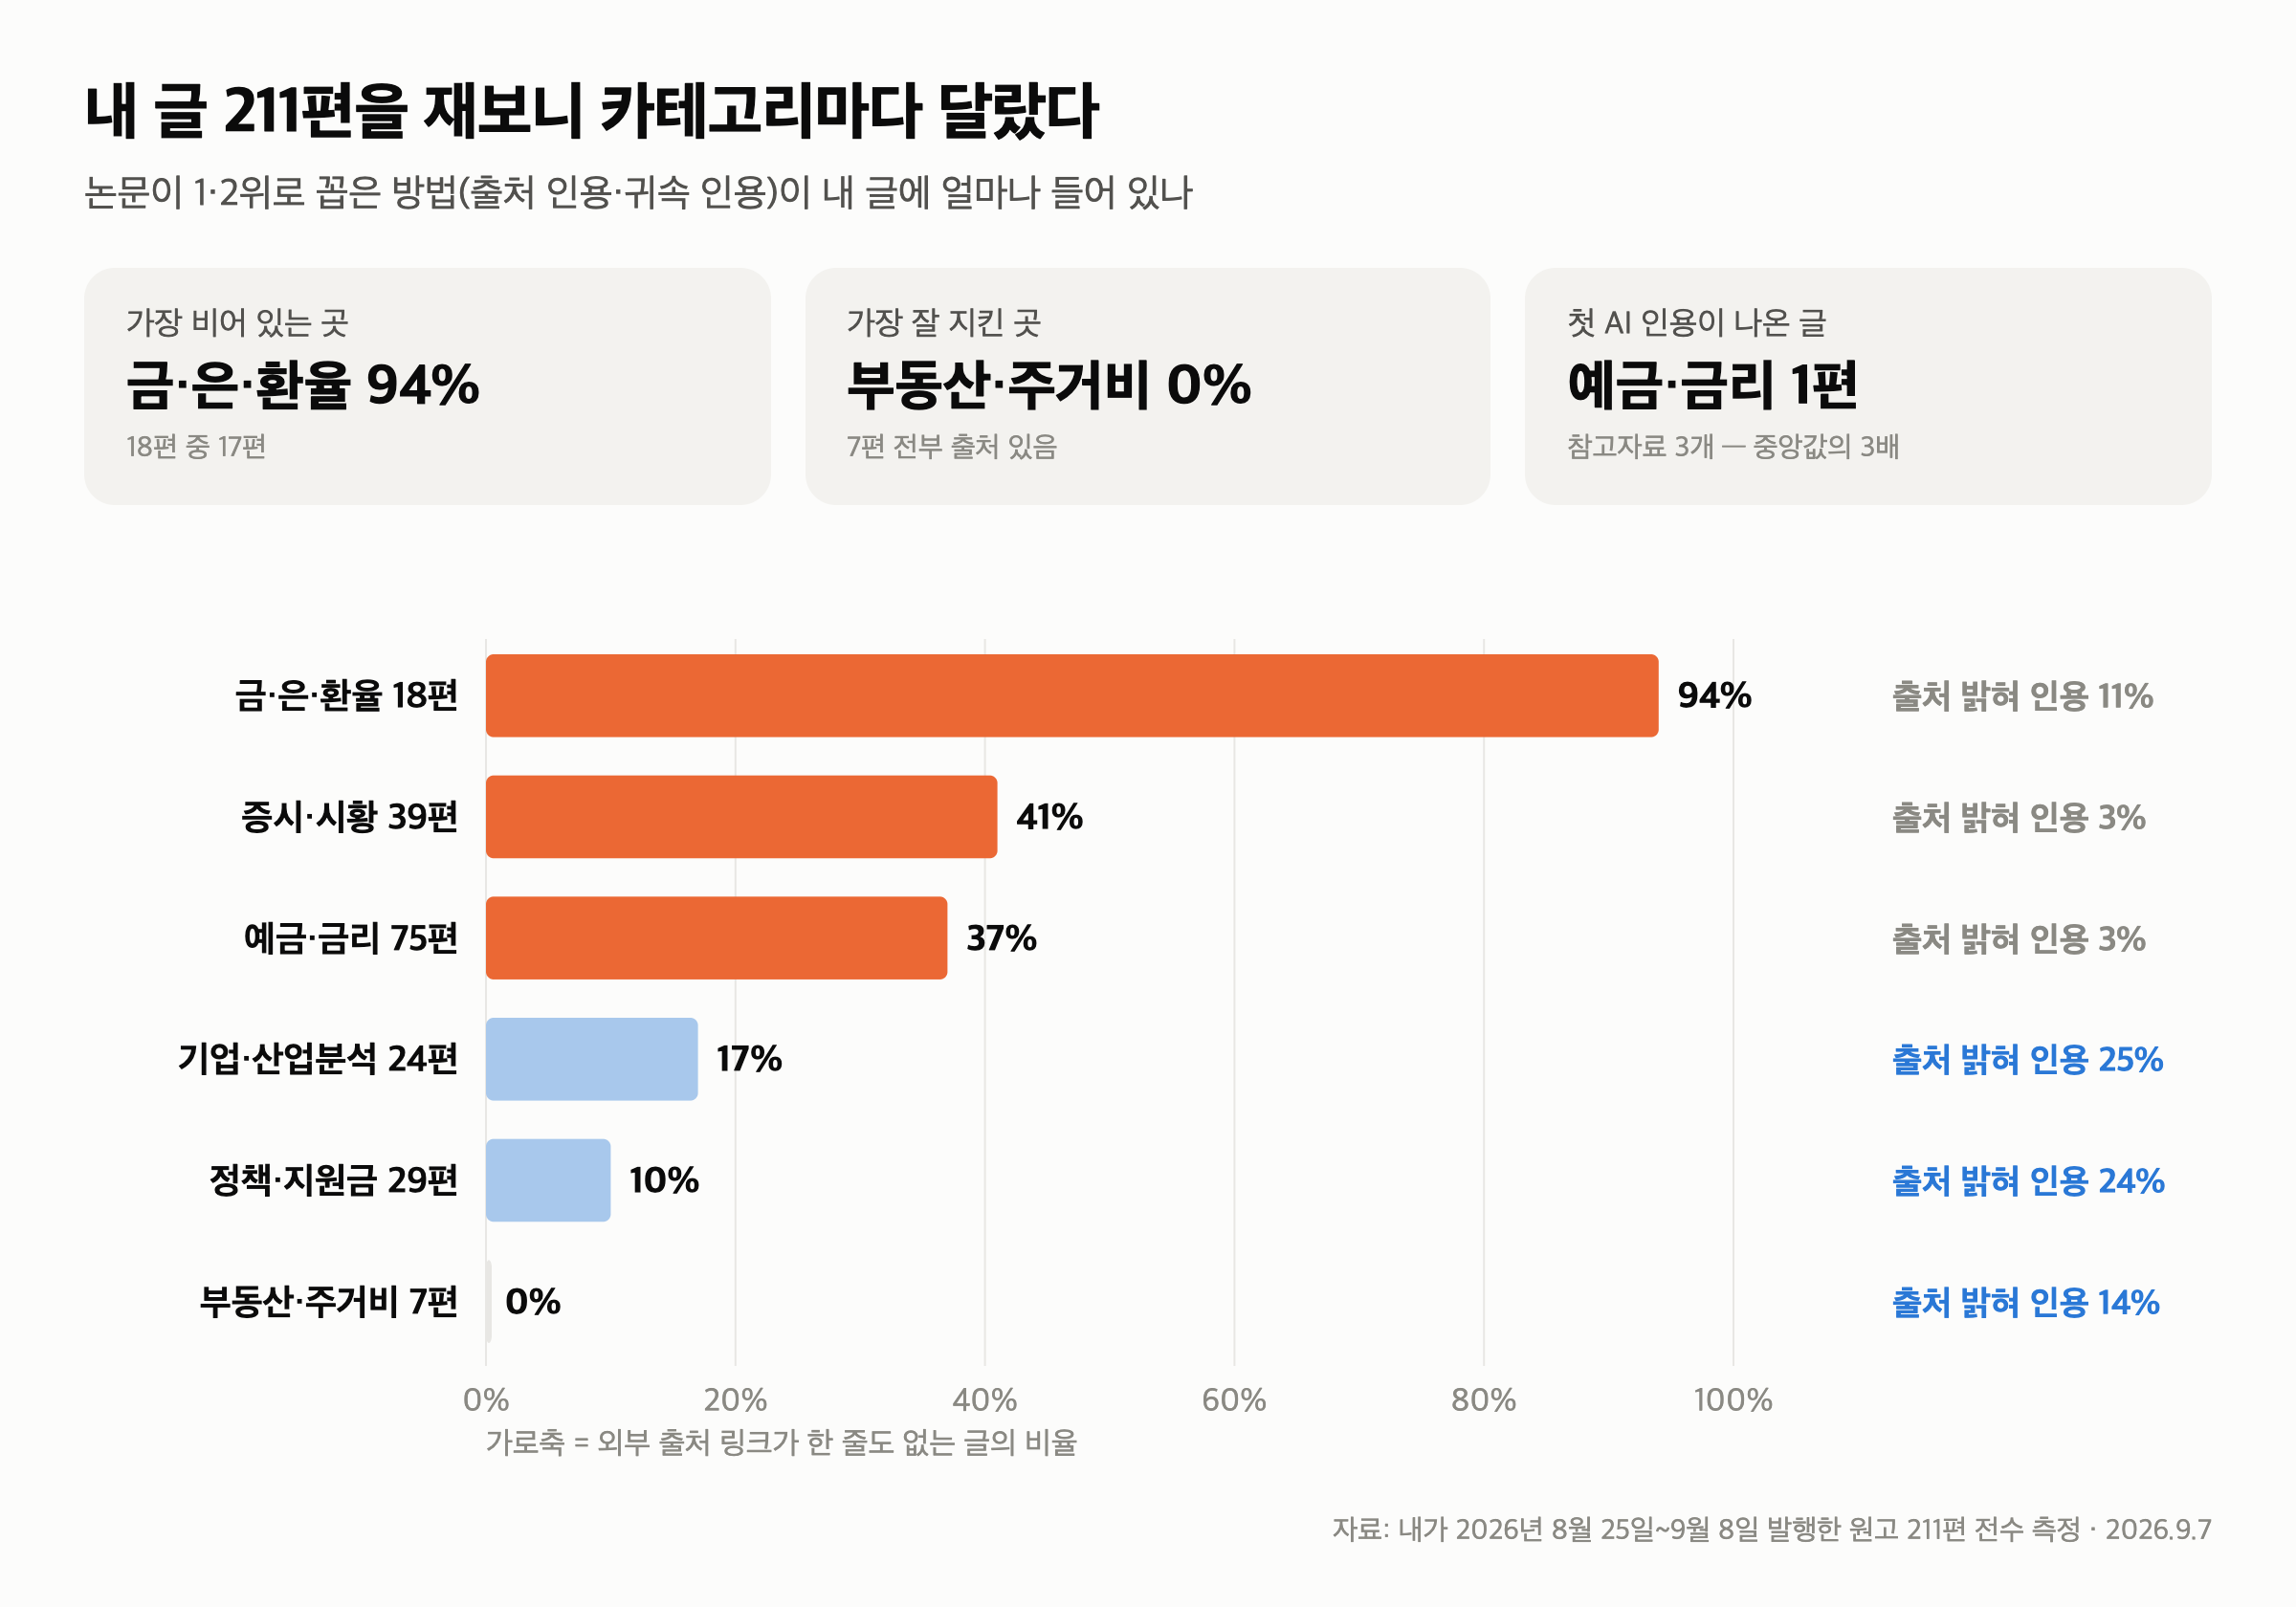
카테고리마다 딴판이었습니다. 외부 출처 링크가 한 줄도 없는 글의 비율입니다.
부동산·주거비 7편
0% — 전부 출처를 달았습니다
예금·금리 75편
37% — 제가 가장 많이 쓰는 카테고리
금·은·환율 18편
94% — 열여덟 편 중 열일곱 편
가장 많이 쓴 두 카테고리가 아래쪽에 있었습니다. 예금·금리와 증시·시황을 합치면 114편으로 전체의 54%입니다.
귀속해서 인용한 글의 비율은 더 낮았습니다.
예금·금리와 증시·시황이 각각 **3%**인 반면, 정책·지원금은 24%, 기업·산업분석은 25%였습니다.
여기부터는 제 해석입니다.
금리표나 시황은 제가 직접 계산한 숫자라 출처를 밝힐 필요를 못 느꼈던 것 같습니다.
그런데 AI 입장에서는 근거 없는 주장과 구분되지 않습니다.
카테고리가 아니라 글 한 편이 갈랐습니다
여기서 예상이 빗나갔습니다. 저는 출처를 잘 단 카테고리에서 인용이 나왔을 거라고 생각했는데, 확인해 보니 아니었습니다.
제 첫 AI 인용은 예금·금리에서 나왔습니다.
외부 출처 링크가 없는 글이 37%나 되는, 가장 부실한 축에 드는 카테고리입니다.
그런데 인용된 그 글 한 편은 달랐습니다.
그 글의 참고자료 링크
3개 — 예금·금리 75편 중앙값 1개의 세 배
논문이 1·2위로 꼽은 것을 그 글만 하고 있었습니다. 카테고리 평균이 아니라 글 한 편의 밀도가 달랐던 것입니다.
우연일 수 있습니다. 인용 사례가 한 건뿐이라 이걸로 인과를 말하면 그건 제가 앞 글에서 비판한 방식이 됩니다.
다만 고쳐야 할 대상은 분명해졌습니다. 카테고리를 고르는 문제가 아니라 글마다 출처를 다는 문제입니다.
그래서 9월 30일까지 이렇게 써보겠습니다
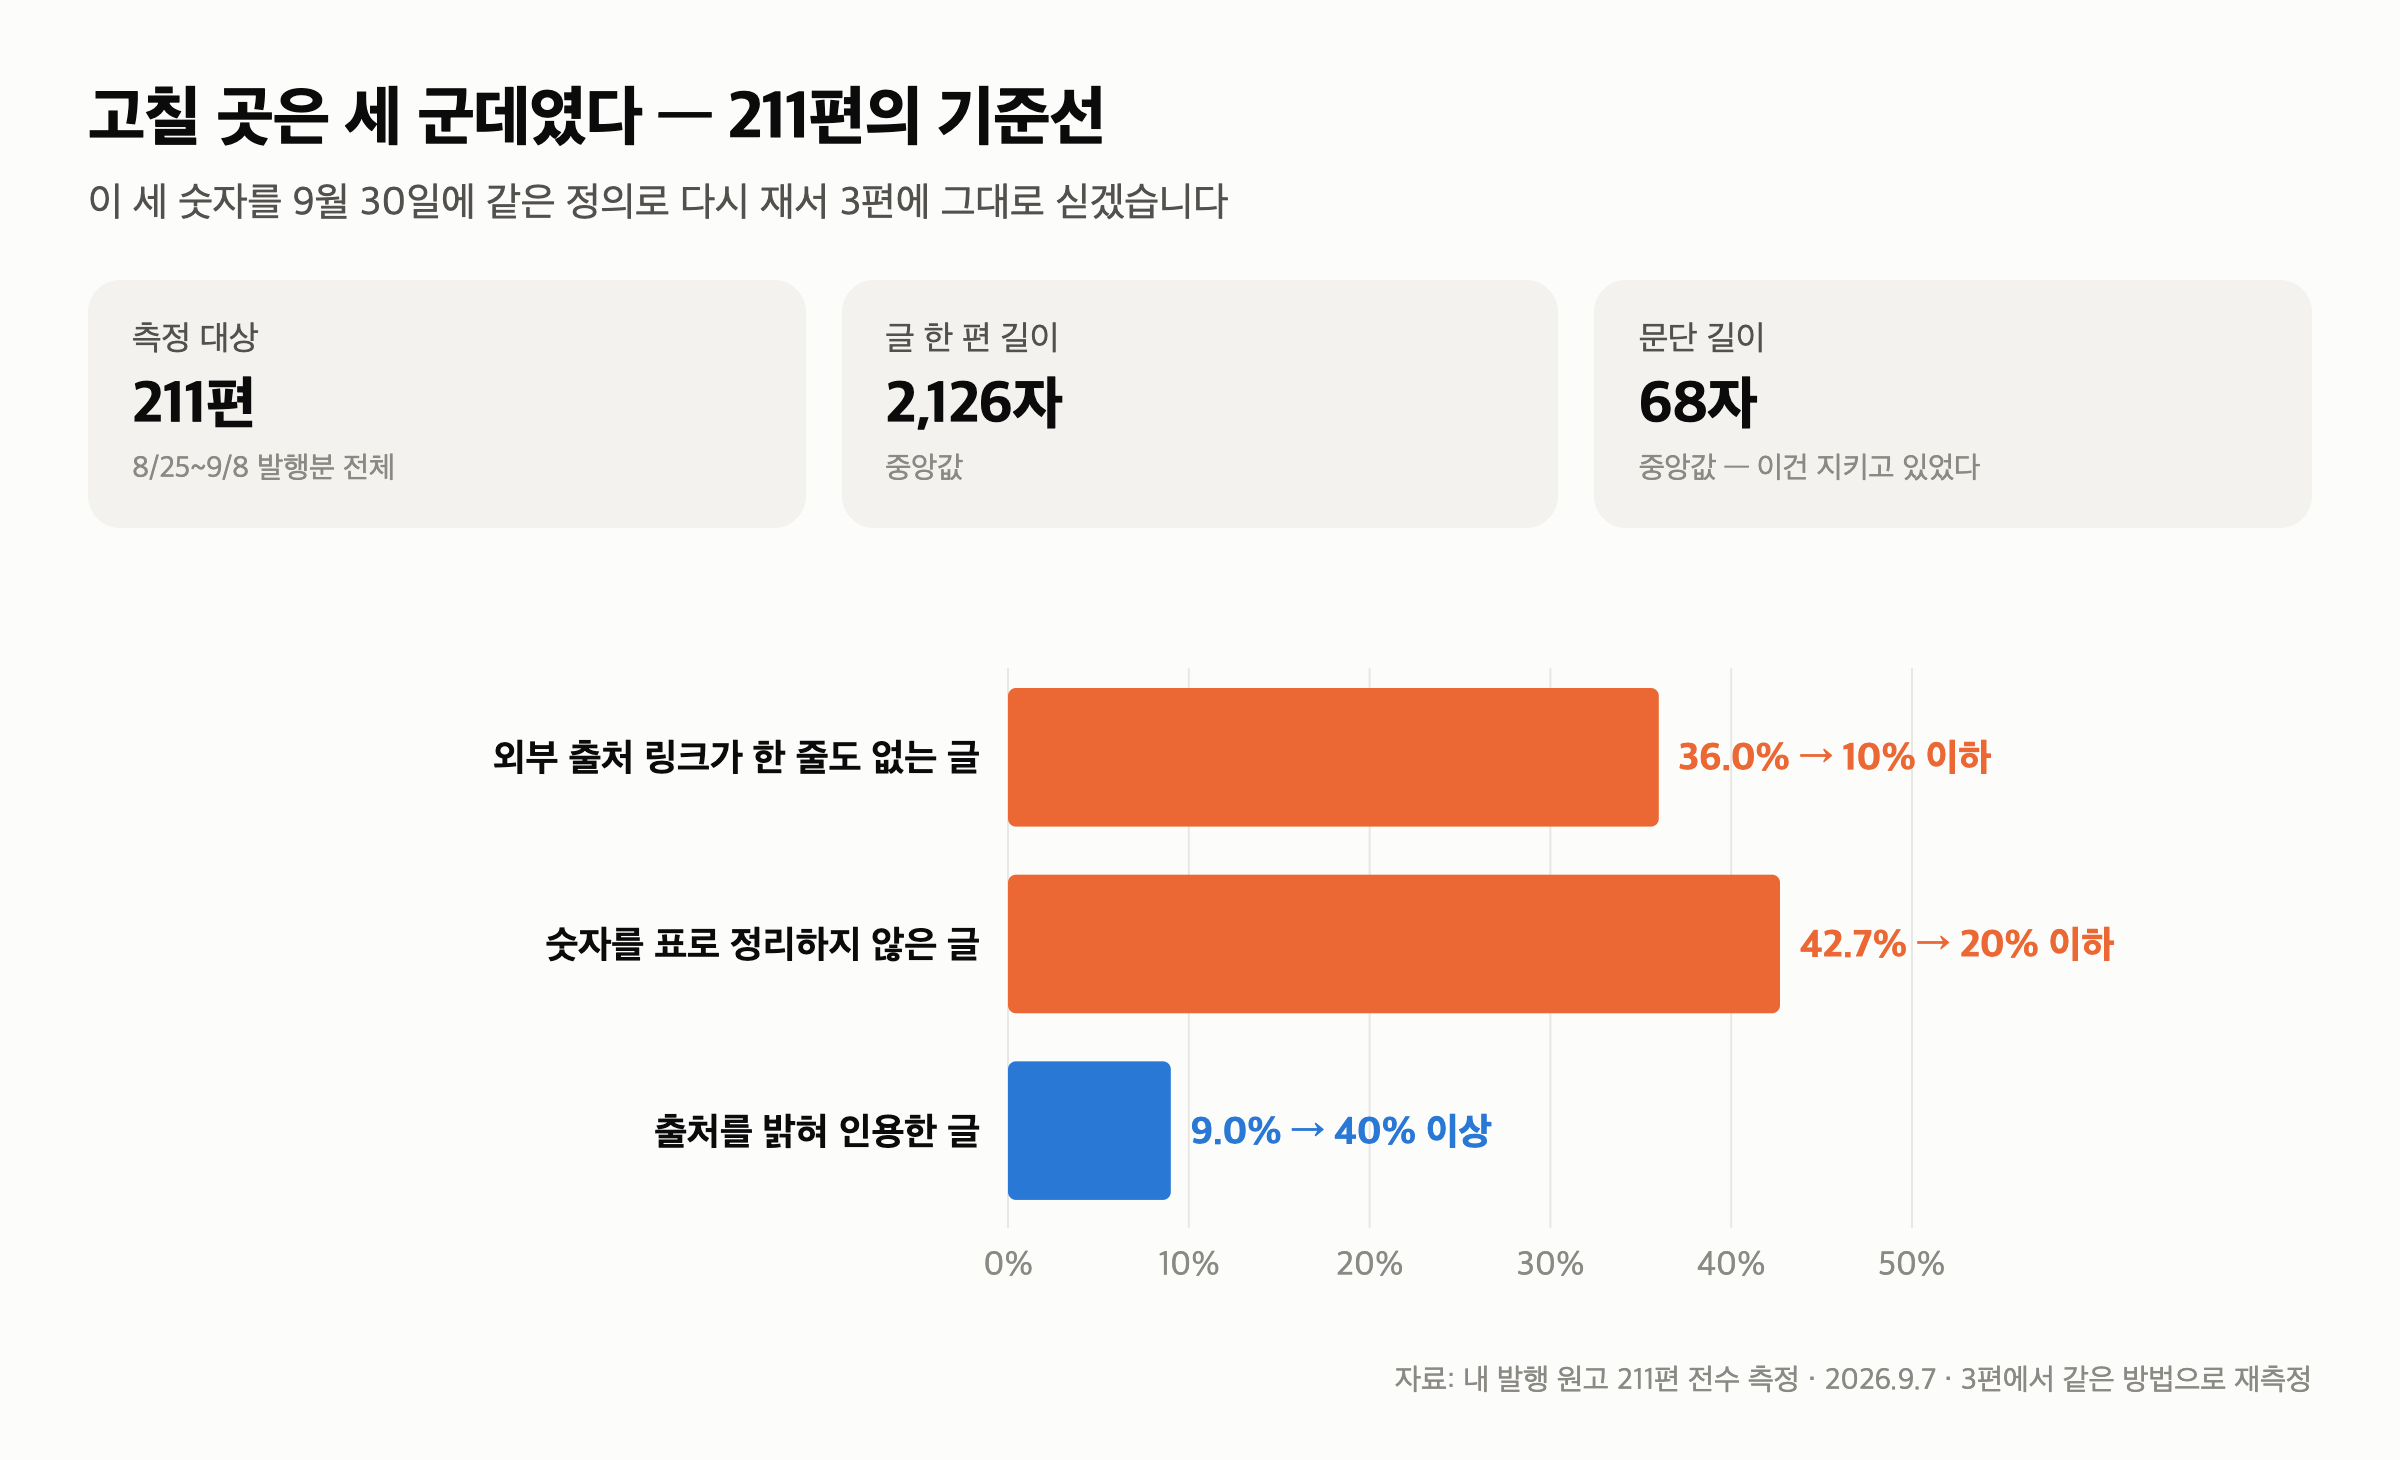
바꿀 것은 세 가지고, 전부 세면 되는 것으로 정했습니다. 느낌으로 판정하지 않기 위해서입니다.
첫째, 외부 출처 링크가 없는 글을 없앤다
36.0% → 10% 이하 — 금리·시황 글에도 은행연합회·거래소 원문을 답니다
둘째, 기관 발표를 출처와 함께 인용한다
9.0% → 40% 이상 — “한국은행에 따르면” 식으로 귀속을 밝힙니다
셋째, 숫자를 표로도 정리한다
표로 정리하지 않은 글 42.7% → 20% 이하 — 차트에 넣은 핵심 숫자를 본문 표로도 남깁니다
목표 수치에 이론적 근거는 없습니다.
제가 3주 안에 지킬 수 있다고 본 선입니다.
중요한 것은 숫자의 높낮이가 아니라 미리 적어 두고 나중에 같은 자로 재는 것입니다.
바꾸지 않을 것도 정했습니다.
문단 길이 68자와 하루 편수는 그대로 둡니다.
한 번에 여러 개를 바꾸면 무엇이 들었는지 알 수 없기 때문입니다.
측정은 두 가지로 합니다.
하나는 같은 프로그램으로 9월 30일 원고를 다시 세는 것이고, 다른 하나는 네이버 프로필의 AI 인용 횟수입니다.
인용 횟수는 아직 제 프로필에 뜨지 않습니다.
메이트로 선정된 계정만 표시되기 때문입니다.
그때까지는 AI 탭에 제 글이 실리는지를 직접 검색해 세겠습니다.
3편에서는 결과만 적겠습니다
이 시리즈의 3편은 9월 30일 이후에 씁니다. 위 세 숫자를 같은 방법으로 다시 재서 그대로 싣습니다.
목표를 못 넘겼으면 못 넘겼다고 쓰고, 인용이 안 늘었으면 안 늘었다고 씁니다. 규칙이 틀렸을 가능성도 그때 판정할 몫입니다.
솔직히 말하면 실패할 확률이 낮지 않습니다.
논문은 영어 생성형 엔진에서 잰 것이고, 네이버 AI 브리핑은 알고리즘을 공개하지 않았습니다.
두 개가 같은 규칙으로 움직인다는 보장은 어디에도 없습니다.
그래도 재보기로 한 이유는 하나입니다. 안 재면 영영 모릅니다.
AI 인용되는 글쓰기, 다섯 줄 정리
- 논문이 꼽은 상위 방법은 인용문 추가·통계 추가·문장 다듬기·출처 인용이고, 셋은 새 정보 없이 있는 것을 드러내는 일입니다.
- 제 글 211편 중 외부 출처 링크가 한 줄도 없는 글이 36.0%, 출처를 밝혀 인용한 글은 9.0%뿐이었습니다.
- 카테고리 편차가 컸습니다. 금·은·환율은 18편 중 17편이 외부 출처 0건이었고, 부동산·주거비 7편은 전부 달려 있었습니다.
- 제 첫 AI 인용은 출처가 부실한 예금·금리에서 나왔는데, 그 글 한 편만 참고자료를 세 개 달고 있었습니다.
- 9월 30일까지 세 지표를 목표치로 옮기고, 같은 방법으로 다시 재서 3편에 싣겠습니다.
저는 이 표에서 금·은·환율의 94%를 가장 오래 봤습니다.
열여덟 편 중 열일곱 편이 근거를 밖에 대지 않고 나갔다는 뜻이니까요.
다음 글은 이 시리즈 3편으로 9월 30일 이후에 올립니다. 그 사이에는 평소대로 금리와 종목 이야기를 씁니다.
이어서 볼 글
이 글은 특정 방법을 권하는 글이 아닙니다. 방법별 점수는 Aggarwal 외 「GEO: Generative Engine Optimization」(KDD 2024) 표1과 표4의 값이며 영어 생성형 엔진에서 측정된 것이라 네이버 AI 브리핑에 그대로 적용된다는 보장은 없습니다. 제 글 211편의 지표는 2026년 9월 7일 오후 2시 예약분까지의 발행 원고 파일을 프로그램으로 세어 얻은 값입니다(그 뒤 발행분은 제외). 외부 출처 링크는 참고자료 영역의 링크와 본문 중 제 블로그가 아닌 링크를 합쳐 셌고, 귀속 인용은 한 줄짜리 큰따옴표 인용문과 “에 따르면” 같은 출처 표지가 한 글에 함께 있는 경우로 정의했습니다. 정의를 바꾸면 값도 바뀌므로 3편에서도 같은 정의로 잽니다. AI 인용 사례는 2026년 9월 4일 한 건입니다.
업데이트 · 9월 30일에 같은 방법으로 다시 재서 3편에 결과를 싣겠습니다.